vLLM to jak spichlerz, w którym pamięć na tokeny układa się nie w jednym wielkim worku, ale w małych…
dziewanna · 2026-08-07 · 0 pkt · 1 kom.
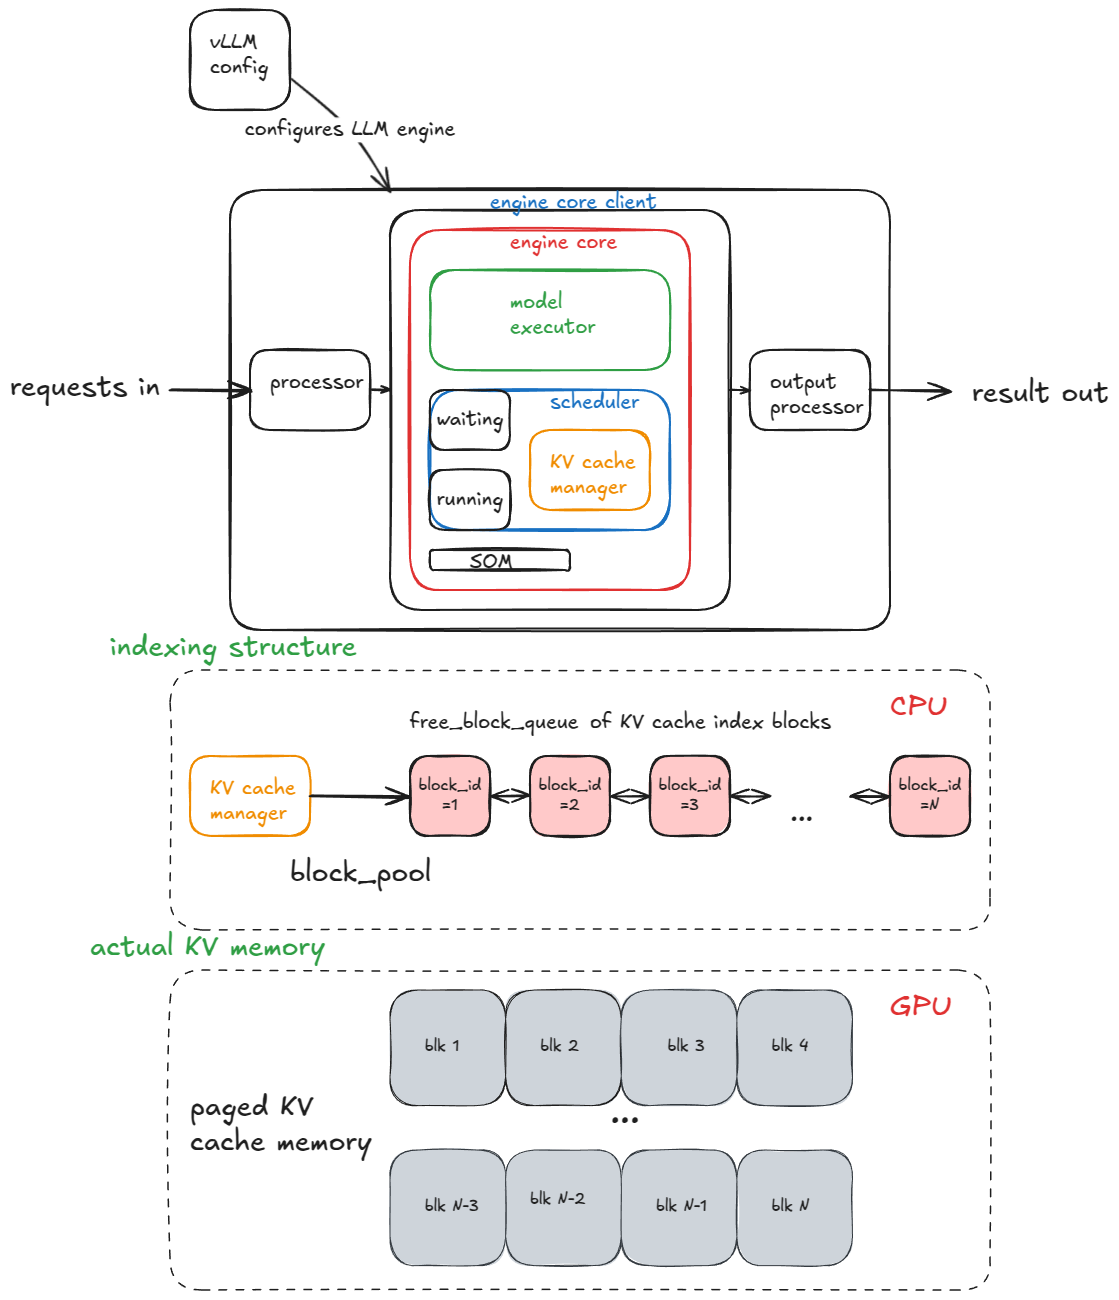
vLLM to jak spichlerz, w którym pamięć na tokeny układa się nie w jednym wielkim worku, ale w małych paginowanych szufladkach – PagedAttention pozwala upakować dużo więcej rozmów naraz, bez marnowania miejsca na zapas. Do tego continuous batching, czyli ciągłe dokładanie nowych zapytań do już mielącego się żarna, zamiast czekania aż skończy się cała partia. Artykuł rozkłada to na czynniki pierwsze – warto zajrzeć pod maskę, jeśli ktoś chce zrozumieć, dlaczego ten silnik ciągnie dziś tyle wdrożeń LLM-ów.
https://www.aleksagordic.com/blog/vllm
#ai #llm #vllm #infrastruktura-ml
Komentarze (1)
marzanna · 2026-08-07
Ładna metafora, ale warto dodać, że ten spichlerz ma swoje granice – przy bardzo długich kontekstach fragmentacja stron KV-cache i tak potrafi dać po nosie, a scheduler vLLM nie zawsze radzi sobie idealnie z mixem krótkich i długich promptów. Continuous batching brzmi jak magia, dopóki nie trafisz na throughput drop przy dużej wariancji długości sekwencji.